Логирование
Логирование (журналирование, logging) в приложении Jmix устроено так же, как в любом приложении Spring Boot: логи пишутся через SLF4J и Logback. Уровни логирования, формат строки и вывод в файл настраиваются стандартными свойствами logging.*, см. Spring Boot Logging.
Уровни логирования
Уровень задаётся в application.properties для пакета или класса:
logging.level.io.jmix=info
logging.level.io.jmix.core.datastore=debug
Уровень можно переопределить при запуске без изменения файла, через переменную окружения. Точки в имени категории заменяются подчёркиваниями:
LOGGING_LEVEL_IO_JMIX_CORE_DATASTORE=DEBUGОсновные категории логирования
Новый проект Jmix содержит в application.properties следующие настройки. Чтобы получить подробный вывод, установите для нужной категории уровень debug.
| Категория | Что выводится на уровне debug |
|---|---|
|
SQL-запросы, которые EclipseLink отправляет в базу данных, и время их выполнения, см. SQL-запросы в контексте трейса |
|
Операции хранилищ данных: какие сущности загружаются и сохраняются |
|
Проверки ограничений доступа. В новом проекте уже включён уровень |
|
Весь отладочный вывод фреймворка |
|
Работа Spring Security: аутентификация, фильтры, решения о доступе. Подробный вывод — уровень |
Уровень debug для io.jmix и eclipselink.logging.sql записывает в лог каждую операцию с данными и каждый SQL-запрос и замедляет приложение, см. Настройка для промышленной эксплуатации.
MDC: контекст записи лога
Сервер обрабатывает запросы разных пользователей одновременно, и строки лога от разных запросов перемешиваются. Чтобы отобрать строки одного запроса, пользователя или бизнес-объекта, в каждую строку нужно добавить признак, по которому их можно найти. Передавать такой признак в каждое сообщение вручную неудобно, а в строки фреймворка, например в SQL-запросы, его передать невозможно.
Эту задачу решает MDC (Mapped Diagnostic Context) — набор пар «ключ — значение», который Logback хранит для текущего потока. Значение, записанное в MDC, автоматически попадает во все строки лога, которые поток пишет после этого: в строки вашего кода, Jmix, EclipseLink и других библиотек. В формате строки значение выводится шаблоном %X{ключ}, а шаблон %X без ключа выводит все пары.
Значения в MDC записывают Jmix, Micrometer Tracing и код приложения:
| Ключ | Кто записывает и когда |
|---|---|
|
Jmix: имя текущего пользователя, см. Имя пользователя в MDC |
|
Micrometer Tracing: идентификаторы текущего трейса и спана, если включена трассировка, см. Идентификаторы трейсов в логах |
Свои ключи |
Код приложения через |
Пример: метод сервиса подтверждает заказ, и все строки, записанные во время подтверждения, должны содержать номер заказа.
try (MDC.MDCCloseable ignored = MDC.putCloseable("orderNumber", order.getNumber())) {
    log.info("Confirming order");
    return dataManager.save(order); (1)
}| 1 | Строки лога DataManager и SQL-запросы, записанные во время сохранения, тоже получат orderNumber. |
MDC.putCloseable() удаляет значение при выходе из блока try. Если значение не удалить, оно останется в потоке и попадёт в строки следующего запроса, который обработает этот поток.
MDC привязан к потоку и не переходит в другие потоки сам. При выполнении кода через @Async, ExecutorService или CompletableFuture значения нужно передать явно, например через MDC.getCopyOfContextMap() и MDC.setContextMap().
Имя пользователя в MDC
Jmix записывает в MDC имя текущего пользователя под ключом jmixUser. Значение устанавливается:
-
при обработке запросов REST API;
-
при выполнении кода от имени другого пользователя через
SystemAuthenticator; -
при выполнении фоновых задач UI.
Стандартный формат строки Spring Boot не выводит MDC. Чтобы имя пользователя появилось в каждой строке, добавьте его в формат уровня:
logging.pattern.level=%5p [%X{jmixUser:-}]Результат:
2026-10-26T11:33:36.050+03:00 DEBUG [petclinic-portal] 18244 --- [nio-8080-exec-6] i.j.core.datastore.AbstractDataStore : loadList: store=main, metaClass=petclinic_Visit, ...Здесь petclinic-portal — пользователь, от имени которого другое приложение обратилось к REST API.
Идентификаторы трейсов в логах
Если в приложении включена трассировка, Micrometer Tracing записывает в MDC идентификаторы текущего трейса и спана, а Spring Boot выводит их в каждой строке лога. Формат вывода задаётся свойством logging.pattern.correlation. Строка лога выглядит так:
11:33:36.050 [http-nio-8080-exec-6] [traceId=b0adeb0946e1bc98796376a316e3561e, spanId=2ab2f07bc8c04434, jmixUser=petclinic-portal] DEBUG i.j.core.datastore.AbstractDataStore - loadList: store=main, metaClass=petclinic_Visit, ...Идентификатор трейса один на весь запрос пользователя, даже если запрос прошёл через несколько приложений: исходящий HTTP-запрос передаёт его в заголовке traceparent, и принимающее приложение продолжает тот же трейс.
Отбор строк лога по идентификатору трейса
Получив строку с ошибкой, вы отбираете по её traceId все остальные строки этого запроса: что пользователь открыл, какие данные загружались, какой SQL выполнялся, в том числе в других приложениях. Строки других запросов, выполнявшихся в это же время, в выборку не попадают. В Grafana Loki такой отбор выполняется запросом LogQL:
{service_name=~"jmix-petclinic.*"} | trace_id="b0adeb0946e1bc98796376a316e3561e"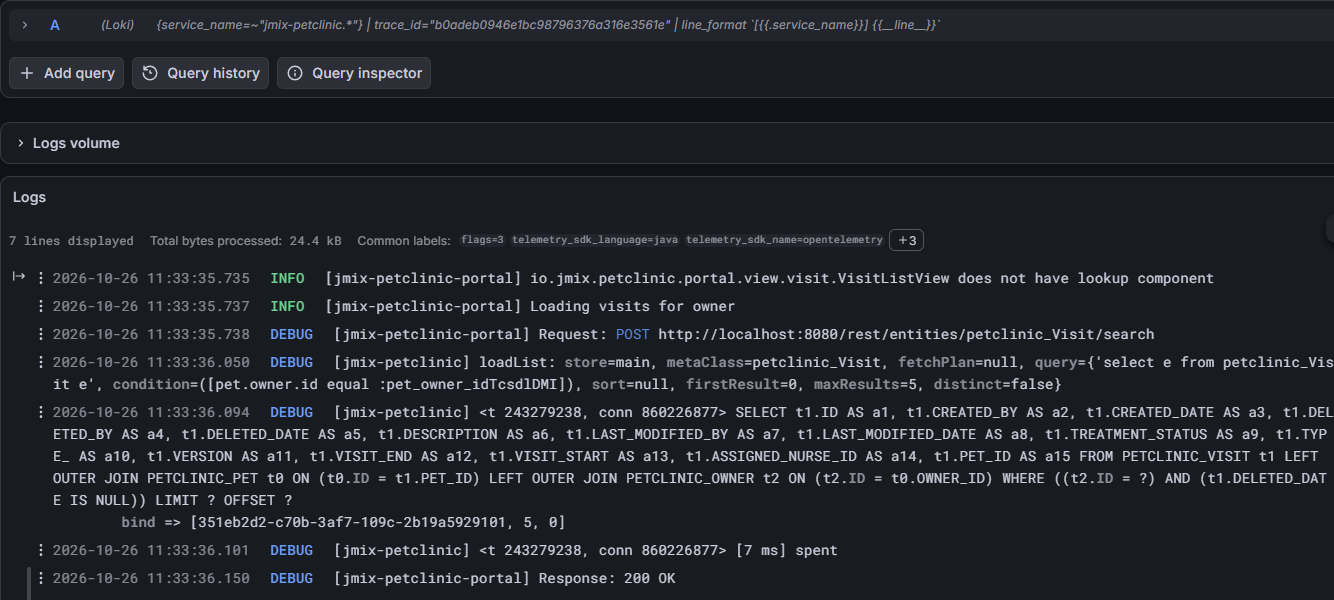
Отобранные строки портала и бэкенда идут в порядке выполнения: портал открывает экран и отправляет REST-запрос, бэкенд загружает визиты и выполняет SQL-запрос с параметрами, портал получает ответ.
Переход между строками лога и трейсами
В подробностях записи лога Grafana показывает значения MDC как атрибуты (jmixUser, trace_id, span_id), а идентификатор трейса — ссылка: из неё открывается трейс с длительностью каждой операции. Из спана трейса, наоборот, открываются строки лога, записанные во время этого спана. Разбор жалобы на медленный экран начинается с трейса, разбор ошибки в логе — с лога.
Отбор строк лога для несохранённых трейсов
Идентификаторы записываются в строки и для запросов, трейсы которых не попали в долю сохраняемых. По traceId строки такого запроса всё равно отбираются, в Loki или обычным поиском по файлу лога.
SQL-запросы в контексте трейса
Если для категории eclipselink.logging.sql установлен уровень debug, EclipseLink записывает в лог каждый SQL-запрос со значениями параметров, а после выполнения — время запроса:
<t 653221857, conn 549323368> SELECT COUNT(ID) FROM PETCLINIC_VISIT WHERE (((ASSIGNED_NURSE_ID = ?) AND (TREATMENT_STATUS <> ?)) AND (DELETED_DATE IS NULL)) LIMIT ? OFFSET ?
	bind => [60885987-1b61-4247-94c7-dff348347f93, DONE, 1, 0]
<t 653221857, conn 549323368> [1 ms] spent
Здесь t — хэш-код потока, conn — хэш-код соединения с базой данных. Время охватывает подготовку запроса, его выполнение и чтение результата, но не ожидание соединения из пула. Строку со временем добавляет сборка EclipseLink, которую использует Jmix.
Строки SQL, как и остальные строки лога, содержат идентификаторы трейса и спана. При включённых спанах доступа к данным идентификатор спана — это спан операции Jmix, во время которой выполнялся запрос, например load list of entities. Поэтому по трейсу видно, какие SQL-запросы породила каждая загрузка данных, см. Доступ к данным.
Число SQL-запросов показывает лишние обращения к базе данных. Следующий запрос LogQL находит трейсы с наибольшим числом SQL-запросов за последние 5 минут:
topk(10, sum by (trace_id) (count_over_time(
  {service_name="jmix-petclinic"} != "spent" | scope_name="eclipselink.logging.sql" [5m]
)))
Здесь scope_name — категория логгера: фильтр по ней оставляет только строки SQL, а условие != "spent" исключает строки со временем выполнения. В результате каждому трейсу соответствует число выполненных в нём SQL-запросов. Если группировать по span_id вместо trace_id, запрос покажет, сколько SQL-запросов выполнила каждая операция загрузки данных.
Сочетание двух группировок различает два вида лишних запросов:
| Результат | Что он означает |
|---|---|
У трейса много SQL-запросов, а у каждой операции загрузки — по одному |
Код выполняет много отдельных загрузок через |
У одной операции загрузки много SQL-запросов |
EclipseLink догружает связанные сущности отдельными запросами. Причину ищут в фетч-плане загрузки |
Каждый trace_id или span_id образует в запросе отдельную серию, а Loki по умолчанию ограничивает их число в одном запросе пятьюстами (параметр limits_config.max_query_series). Если ограничение превышено, уменьшите окно, например до [1m], или сузьте выборку, например по пользователю: | jmixUser="admin".
Настройка для промышленной эксплуатации
-
Постоянный уровень логирования —
infoилиwarn; уровеньdebugвключается для отдельной категории на время разбора. Уровень меняется без перезапуска через эндпойнт Actuatorloggers, см. Spring Boot Loggers. Эндпойнтloggersменяет настройки приложения, поэтому его закрывают от анонимного доступа. -
Вывод SQL (
eclipselink.logging.sql) постоянно не включают: в лог записывается текст каждого запроса к базе данных, и объём логов многократно возрастает. Для постоянного наблюдения достаточно спанов загрузки данных: в них записываются текст JPQL-запроса и значения его параметров, а длительность операций с данными видна в метрикахjmix.data.*. Вывод SQL включают на время разбора, см. SQL-запросы в контексте трейса. -
Подробное логирование каждого шага не требуется: строки одного запроса отбираются по
traceId, см. Идентификаторы трейсов в логах. -
Срок хранения логов в Loki задаётся параметром
limits_config.retention_periodпри включённомcompactor.retention_enabled.
Централизованный сбор логов
Когда приложение работает в нескольких экземплярах или состоит из нескольких сервисов, логи собирают в общую систему хранения, например Grafana Loki или Elasticsearch. Для отправки логов по протоколу OTLP используется OpenTelemetry Logback appender. Appender передаёт идентификаторы трейсов и, если это указано в его настройках, значения MDC как атрибуты записи, по которым затем фильтруются логи.
В Grafana логи из Loki просматриваются без написания запросов в Drilldown → Logs: логи группируются по сервисам и уровням, выборка сужается по атрибутам, например по имени пользователя из MDC. Для сложных отборов используется Explore с запросами LogQL.
Начальная страница Drilldown → Logs показывает все приложения, которые отправляют логи: для каждого — гистограмму числа строк по уровням и последние строки. Уровень выделен цветом, поэтому всплеск предупреждений или ошибок заметен сразу.
Например, пока база данных остановлена, на гистограмме бэкенда (jmix-petclinic) появляются строки WARN от пула соединений HikariCP, а на гистограмме портала — предупреждения в те же моменты.
Страница одного приложения показывает гистограмму всех его строк по уровням и сами строки. В примере с остановленной базой на гистограмме виден провал: запросы ждали соединения и не писали строк. Сразу после провала идут предупреждения пула соединений. Над гистограммой выбираются уровни, поля и текстовый фильтр.
Пошаговая настройка с примером из двух приложений и Grafana описана в руководствах: