Метрики
Метрики приложения Jmix собираются через Micrometer, как в любом приложении Spring Boot. Spring Boot Actuator предоставляет метрики JVM, процессора, пулов потоков, HTTP-запросов и пулов соединений с базой данных, см. Spring Boot Metrics. На этой странице описаны метрики, которые добавляет Jmix, и их экспорт.
Метрики — числовые показатели, которые приложение записывает непрерывно и которые занимают мало места при хранении. Поэтому их собирают постоянно, в том числе на серверах в промышленной эксплуатации. По накопленным метрикам видно, как меняется производительность от версии к версии; на их основе настраиваются оповещения о нештатных ситуациях; при инциденте они показывают, когда и в какой части приложения начались проблемы, а дальше разбор продолжается по трейсам и логам.
Включение метрик Jmix
Метрики наблюдений Jmix записываются, а все метрики становятся доступны для экспорта, только при подключённом Spring Boot Actuator:
implementation 'org.springframework.boot:spring-boot-starter-actuator'Группы метрик включаются свойствами:
| Свойство | По умолчанию | Метрики |
|---|---|---|
|
|
|
|
|
|
|
|
Таймеры и их серии
Все метрики Jmix — таймеры. Метрики jmix.data.* и jmix.ui.* получаются из наблюдений Micrometer: каждое наблюдение даёт две метрики.
-
Timer с именем наблюдения, например
jmix.ui.views. Учитывает завершённые операции: их количество, суммарную и максимальную длительность. Тегerrorсодержит имя класса исключения илиnone, если операция завершилась без ошибки. -
LongTaskTimer с суффиксом
.active, напримерjmix.ui.views.active. Показывает операции, которые выполняются в данный момент: их количество и текущую длительность.
В Prometheus точки в именах заменяются подчёркиваниями, а к имени добавляется единица измерения и вид серии. Например, Timer jmix.ui.views даёт серии:
| Серия | Значение |
|---|---|
|
Количество завершённых операций |
|
Суммарная длительность операций в секундах |
|
Максимальная длительность за последний интервал |
Средняя длительность за интервал вычисляется делением приращений суммы и количества:
rate(jmix_ui_views_seconds_sum[5m]) / rate(jmix_ui_views_seconds_count[5m])Перцентили и гистограммы включаются стандартными свойствами Spring Boot, см. Настройка метрик средствами Spring Boot.
Остальные метрики на этой странице описаны по имени, без перечисления серий.
Настройка метрик средствами Spring Boot
Метрики Jmix — обычные метрики Micrometer, поэтому к ним применимы все стандартные настройки Spring Boot. Свойства принимают имя метрики или его начало: значение для jmix действует на все метрики Jmix, для jmix.ui.views — на одну метрику. Полный список свойств — в разделе Customizing Individual Metrics.
Перцентили
Среднее значение скрывает редкие медленные операции, а перцентиль показывает время, в которое укладывается заданная доля операций. Свойство management.metrics.distribution.percentiles-histogram включает гистограмму, по которой перцентиль вычисляется в Prometheus функцией histogram_quantile() и складывается по всем экземплярам приложения. Свойство management.metrics.distribution.percentiles включает вычисление заданных перцентилей в самом приложении; их нельзя складывать между экземплярами. Гистограмма добавляет к каждой серии несколько десятков серий, поэтому её включают только для нужных метрик.
management.metrics.distribution.percentiles-histogram.jmix.ui.data=trueНапример, когда 95-й перцентиль загрузчика visitsDl кратковременно вырос до 295 мс, средняя длительность этапа beforeShow того же экрана выросла только с 80 до 113 мс. Запросы для таких графиков приведены в разделе Визуализация в Grafana.
Отключение и фильтрация
Свойство management.metrics.enable отключает отдельные метрики, management.observations.enable — наблюдения целиком, вместе со спанами. Свойство management.metrics.observations.ignored-meters=long-task-timer отключает LongTaskTimer у всех наблюдений и почти вдвое сокращает число серий. Свойство management.metrics.tags добавляет общие теги ко всем метрикам, например имя приложения.
Правила, которые свойствами не выразить, задаются бинами MeterFilter: удалить метрику по условию, удалить или переименовать тег, ограничить число значений тега. Наблюдения фильтруются бинами ObservationPredicate и ObservationFilter.
Метрики доступа к данным
Включаются свойством jmix.core.data-observation-enabled=true.
jmix.data.load
Длительность операций чтения через DataManager, а значит, и через репозитории Jmix, загрузчики данных UI и REST API. Прямые запросы через EntityManager и JDBC не измеряются.
| Тег | Значение |
|---|---|
|
Операция: |
|
Имя сущности, например |
jmix.data.save
Длительность сохранения и удаления сущностей через DataManager и все пути поверх него, перечисленные для jmix.data.load.
| Тег | Значение |
|---|---|
|
Всегда |
|
Имя хранилища данных, например |
Частота и длительность загрузок по сущностям
Метрика jmix.data.load с тегами entity.name и method показывает, какие сущности загружаются чаще всего и дольше всего. Частота загрузок по сущностям:
sum by (entity_name, method) (rate(jmix_data_load_seconds_count[5m]))Средняя длительность загрузки по сущностям:
sum by (entity_name) (rate(jmix_data_load_seconds_sum[5m]))
/
sum by (entity_name) (rate(jmix_data_load_seconds_count[5m]))
Если сущность загружается заметно чаще, чем открываются экраны, которые её показывают, вероятна загрузка в цикле (проблема N+1). Какие именно запросы выполняются, показывают спаны и строки SQL в логе, см. Доступ к данным.
Пул соединений с базой данных
Spring Boot публикует метрики пула соединений HikariCP с тегом pool — именем пула. Они показывают, ждут ли операции доступа к данным свободного соединения:
| Метрика | Значение |
|---|---|
|
Число соединений, занятых в данный момент |
|
Максимальный размер пула |
|
Число потоков, ожидающих свободного соединения |
|
Время ожидания соединения (Timer) |
|
Время, в течение которого соединение было занято (Timer) |
|
Число отказов в выдаче соединения по тайм-ауту |
Если hikaricp.connections.pending больше нуля, а hikaricp.connections.active равно максимальному размеру пула, операции ждут соединения. Время ожидания входит в длительность спанов загрузки данных, но не во время SQL-запросов в логе. Пул бывает занят из-за медленных запросов, долгих транзакций или слишком маленького размера пула. Размер пула основного хранилища данных задаётся свойством main.datasource.hikari.maximum-pool-size.
Метрики UI
Включаются свойством jmix.ui.ui-observation-enabled=true.
В приложении на Vaadin стандартная метрика Spring Boot http.server.requests не показывает, какой экран открывается медленно и какое действие пользователя выполняется долго. Vaadin передаёт все действия пользователя запросами к одному адресу, и в этой метрике они образуют одну серию POST /**. Метрики jmix.ui.* различают экраны, этапы их жизненного цикла, загрузчики данных и действия.
Если идентификатор экрана, фрагмента или компонента не определён, тег получает значение N/A.
jmix.ui.views
Длительность этапов жизненного цикла экранов.
| Тег | Значение |
|---|---|
|
Этап: |
|
Идентификатор экрана, например |
|
Полное имя класса экрана |
Экран-layout, например MainView, при переходе между вложенными экранами не создаётся заново, но проходит этапы beforeShow, ready, beforeClose и afterClose. Поэтому число этапов ready у layout намного больше числа этапов create, и среднее время открытия считают по каждому этапу отдельно, а не делят общее время всех этапов на число ready.
jmix.ui.fragments
Длительность этапов жизненного цикла фрагментов.
| Тег | Значение |
|---|---|
|
Этап: |
|
Полное имя класса фрагмента |
|
Идентификатор фрагмента в дескрипторе |
|
Идентификатор экрана, в котором находится фрагмент |
jmix.ui.data
Длительность этапов работы загрузчиков данных.
| Тег | Значение |
|---|---|
|
Этап: |
|
Идентификатор загрузчика. Для загрузчиков без явного идентификатора — |
|
Идентификатор экрана |
|
Идентификатор фрагмента, если загрузчик объявлен во фрагменте |
jmix.ui.actions
Длительность выполнения действий UI. Дополнения AI Chat, Tabbed Mode и Dynamic Model записывают свои действия в эту же метрику.
| Тег | Значение |
|---|---|
|
Идентификатор действия |
|
Идентификатор компонента, к которому привязано действие |
|
Идентификатор экрана |
|
Идентификатор фрагмента, если действие объявлено во фрагменте |
jmix.EmailSender.send
Длительность отправки email-сообщения через EmailSender дополнения Email. Обычный Timer без собственных тегов.
Теги пользователя и арендатора
В приложениях с мультиарендностью при включённом свойстве jmix.core.use-user-info-for-observation (значение по умолчанию) метрики jmix.data.* и jmix.ui.* получают тег jmix.user.tenantId с идентификатором арендатора текущего пользователя. Имя пользователя в метрики не попадает, оно записывается только в спаны.
Устаревшая схема UI-метрик
До версии 3.0 метрики jmix.ui.views и jmix.ui.data записывались с другими тегами. Эта схема сохранена для существующих панелей мониторинга и включается свойством jmix.ui.legacy-monitoring-enabled=true. Свойство устарело и будет удалено в одном из следующих релизов. При обновлении проекта до 3.0 Studio устанавливает его в true.
Соответствие тегов:
| Метрика | Устаревший тег | Тег в новой схеме |
|---|---|---|
|
|
|
|
|
|
— |
|
|
|
|
|
|
|
|
|
|
Значения этапов жизненного цикла в обеих схемах совпадают. Метрик фрагментов и действий в устаревшей схеме нет.
Свойства jmix.ui.ui-observation-enabled и jmix.ui.legacy-monitoring-enabled независимы:
ui-observation-enabled |
legacy-monitoring-enabled |
Записываемые UI-метрики |
|---|---|---|
|
|
Нет |
|
|
Все метрики UI в новой схеме |
|
|
|
|
|
|
Когда включены оба свойства, метрики новой схемы с тегом lifecycle.name не записываются, чтобы не конфликтовать с одноимёнными метриками устаревшей схемы. Под это правило попадают и jmix.ui.fragments, хотя устаревшего аналога у них нет. Спаны записываются полностью.
Чтобы перейти на новую схему, переведите панели мониторинга и правила оповещений на новые теги, установите jmix.ui.ui-observation-enabled=true и удалите jmix.ui.legacy-monitoring-enabled.
Эндпойнт Prometheus
Добавьте реестр Prometheus:
implementation 'org.springframework.boot:spring-boot-starter-actuator'
implementation 'io.micrometer:micrometer-registry-prometheus'
Откройте эндпойнт prometheus через веб:
management.endpoints.web.exposure.include=health,prometheusСистема мониторинга периодически опрашивает эндпойнт /actuator/prometheus и сохраняет полученные значения. Кроме Prometheus, этот формат поддерживают и другие системы (VictoriaMetrics, Zabbix, OpenTelemetry Collector и другие).
Если система мониторинга не опрашивает приложение, а принимает метрики сама, подключите реестр Micrometer для этой системы (например, micrometer-registry-datadog или micrometer-registry-influx) или используйте экспорт по OTLP. Список поддерживаемых систем приведён в Spring Boot Metrics.
Не открывайте все эндпойнты значением *: часть из них показывает настройки и внутреннее состояние приложения. Настройте доступ к эндпойнтам Actuator в конфигурации безопасности приложения.
Экспорт по OTLP
Если приложение уже отправляет трейсы через OpenTelemetry (см. Экспорт через OpenTelemetry), метрики можно отправлять в тот же сборщик:
management.otlp.metrics.export.url=http://localhost:4318/v1/metricsЗначение по умолчанию — http://localhost:4318/v1/metrics, поэтому при локальном сборщике на стандартном порту метрики отправляются и без этого свойства.
При экспорте по OTLP имена серий в Prometheus отличаются от имён, которые даёт эндпойнт /actuator/prometheus. Например, для Timer jmix.ui.views в стеке grafana/otel-lgtm:
/actuator/prometheus |
OTLP |
|---|---|
|
|
|
|
|
нет |
|
|
Запросы PromQL на этой странице записаны для эндпойнта /actuator/prometheus. При экспорте по OTLP замените в них _seconds на _milliseconds; значения длительности будут в миллисекундах.
При экспорте по OTLP не передаются и exemplars, поэтому перейти от графика метрики к трейсу нельзя.
Приложение отправляет метрики с интервалом, который задаёт свойство management.otlp.metrics.export.step; по умолчанию 1m. Окно функций rate() и increase() в запросах должно вмещать хотя бы две отправки, то есть при интервале 1m — не меньше 2m. Иначе график покажет «No data».
Метрики бизнес-операций
Метрики приложения регистрируются через тот же MeterRegistry, что и метрики Jmix, и экспортируются вместе с ними. Инжектируйте MeterRegistry в бин и создайте нужный измеритель: Counter для количества событий, например оформленных заказов; Timer для длительности операций; Gauge для текущего значения, например длины очереди. См. Micrometer Meters.
Если операцию нужно видеть и в метриках, и в трейсах, оберните её в наблюдение Observation: Micrometer создаст для него таймер и спан одновременно, как для наблюдений Jmix. Пример — в разделе Спаны бизнес-операций.
Именуйте метрики через точку и с префиксом приложения, например sales.orders.confirmed, а в теги выносите только значения из небольшого фиксированного набора. Идентификаторы сущностей, имена пользователей и тексты в тегах создают отдельную серию на каждое значение, и число хранимых серий растёт вместе с числом пользователей или сущностей.
Пример бизнес-метрик — число активных пользователей приложения за день, неделю и месяц (DAU, WAU, MAU): статья Monitoring Active Users in Enterprise Applications with Jmix и пример приложения jmix-app-usage-metrics-sample с панелью мониторинга Grafana.
Визуализация в Grafana
Grafana подключается к Prometheus как к источнику данных. Панель мониторинга Grafana состоит из элементов визуализации. У каждого элемента есть запрос на языке PromQL и вид отображения: график во времени, таблица, отдельное число. Переменные панели мониторинга, например список приложений или экранов, заполняются значениями меток и подставляются в запросы элементов: выбрав экран в списке, вы видите данные только по нему.
Чтобы посмотреть метрики без написания запросов, откройте Drilldown → Metrics: Grafana покажет графики всех метрик из Prometheus и позволит сузить выборку по меткам. Так находят нужную метрику и её метки перед построением графика.
В Prometheus точки в именах тегов заменяются подчёркиваниями: тег view.id становится меткой view_id, lifecycle.name — lifecycle_name.
Десять экранов с наибольшей средней длительностью этапа beforeShow за последние 5 минут:
topk(10,
  sum by (view_id) (rate(jmix_ui_views_seconds_sum{lifecycle_name="beforeShow"}[5m]))
  /
  sum by (view_id) (rate(jmix_ui_views_seconds_count{lifecycle_name="beforeShow"}[5m]))
)
95-й перцентиль длительности загрузки данных по загрузчикам. Запрос требует включённой гистограммы для jmix.ui.data:
histogram_quantile(0.95,
  sum by (le, view_id, loader_id) (rate(jmix_ui_data_seconds_bucket{lifecycle_name="load"}[5m]))
)
Панель мониторинга из четырёх графиков на таких запросах показана в разделе Перцентили. Метрики на ней отправлены по OTLP, поэтому в запросах использованы серии _milliseconds.
Если метрики нескольких приложений хранятся в одном Prometheus, добавьте ко всем метрикам приложения общий тег с его именем. По этому тегу панель мониторинга разделяет приложения:
management.metrics.tags.application=salesExemplars
Exemplar — значение отдельного измерения метрики вместе с идентификаторами трейса и спана, в которых это измерение сделано. Grafana выводит exemplars точками поверх графика метрики. Точка показывает длительность конкретной операции и открывает её трейс: от всплеска на графике можно сразу перейти к запросу, который его вызвал.
Если в приложении включена трассировка, реестр Prometheus прикрепляет exemplars к сериям таймеров, в том числе таймеров Jmix: к серии _count, а при включённой гистограмме — и к сериям _bucket. Гистограмма для exemplars не обязательна. Эндпойнт /actuator/prometheus отдаёт exemplars только в формате OpenMetrics; Prometheus 3 запрашивает этот формат по умолчанию.
Переход от графика к трейсу требует трёх настроек:
-
Prometheus запущен с параметром
--enable-feature=exemplar-storage. Без него полученные exemplars не сохраняются. -
В настройках источника данных Prometheus в Grafana, в разделе Exemplars, добавлена ссылка: метка
trace_idи источник данных трейсов, например Tempo. -
В запросе элемента визуализации включён переключатель Exemplars.
Exemplar ведёт только к трейсу; логи и профиль открываются уже из трейса. Кнопка Logs for this span в подробностях спана показывает строки лога этого трейса, если в источнике данных Tempo настроен переход к логам (Trace to logs), см. Переход между строками лога и трейсами. Кнопка Profiles for this span у корневого спана запроса открывает профиль процессора за время этого спана, если подключена связь профилей со спанами.
Реестр OTLP в Micrometer exemplars не передаёт. Чтобы связать метрики с трейсами, которые отправляются по OTLP, метрики собирают с эндпойнта /actuator/prometheus, а трейсы по-прежнему отправляют по OTLP.
Например, на графике средней длительности загрузки petclinic_Owner, около 40 мс, над линией стоит точка exemplar: одна загрузка этой сущности длительностью 168 мс (значение 0.168 в секундах). Ссылка Trace в подсказке точки открывает трейс этой загрузки в Explore. Ctrl+щелчок по ссылке открывает трейс в новой вкладке, и панель мониторинга остаётся открытой.
Готовые панели мониторинга
Стандартные панели мониторинга Jmix для Grafana опубликованы в репозитории jmix-grafana-dashboards. Панель мониторинга хранится в JSON-файле и загружается в Grafana через Dashboards → New → Import; при импорте укажите источник данных Prometheus. Её можно использовать как есть, взять за образец для своих элементов визуализации или адаптировать: изменить запросы, удалить ненужные элементы, добавить элементы с метриками своего приложения.
Панель мониторинга «Jmix 3 Monitoring» показывает метрики, которые Prometheus собирает с эндпойнта /actuator/prometheus. Она построена на метриках новой схемы тегов и рассчитана на включённые jmix.ui.ui-observation-enabled и jmix.core.data-observation-enabled. Приложения различаются по общему тегу application, см. Визуализация в Grafana. Гистограммы для этой панели мониторинга не нужны: длительность операций на ней показана средним и максимальным значением таймера. Максимум — самая долгая операция за последние минуты; он показывает редкие медленные операции, которые скрывает среднее значение.
В верхней строке выбираются источник данных, приложение, экземпляр, экраны, загрузчики данных и сущности. Разделы панели мониторинга:
-
Overview — частота открытия экранов, активные HTTP-сессии, частота операций
DataManager, ответов HTTP 5xx и операций Jmix, завершившихся ошибкой, среднее время открытия экрана, максимальное время закрытия экрана, среднее и максимальное время загрузчиков данных; -
Views — частота, среднее и максимальное время открытия по экранам, среднее и максимальное время этапов открытия, экраны с наибольшим временем открытия, среднее и максимальное время закрытия по экранам. Время открытия — сумма средних времён этапов открытия, каждый из которых усредняется по своему числу вызовов. Частота открытия считается по этапу
ready, поэтому для экрана-layout в неё входит каждая навигация, см. jmix.ui.views; -
Data loaders — среднее и максимальное время загрузки по загрузчикам, частота загрузки, загрузчики с наибольшим временем загрузки, среднее и максимальное время этапов загрузчиков. Этапы
preLoadиpostLoad— обработчикиPreLoadEventиPostLoadEventв коде приложения,load— сама загрузка; -
Fragments — среднее и максимальное время этапов фрагментов. Этап
readyфрагмента записывается со значениемN/Aтегаview.id, поэтому фильтр экранов этот этап не сужает; -
Actions — частота, среднее и максимальное время выполнения действий;
-
Data access — частота, среднее и максимальное время загрузки
DataManagerпо сущностям, частота, среднее и максимальное время сохранения, пул соединений с базой данных; -
HTTP and JVM — HTTP-запросы по результату, загрузка процессора, память, доля времени в паузах сборки мусора, потоки по состояниям;
-
Operations in progress — операции, которые начались и ещё не завершились: их число и длительность самой долгой из них. Раздел строится по метрикам LongTaskTimer (
*.active), см. Таймеры и их серии. Зависшая операция видна здесь до своего завершения. Если LongTaskTimer отключены свойствомmanagement.metrics.observations.ignored-meters=long-task-timer, раздел остаётся пустым.
Панели, которые не нужны, удаляются в режиме редактирования панели мониторинга, а раздел целиком сворачивается щелчком по его заголовку.
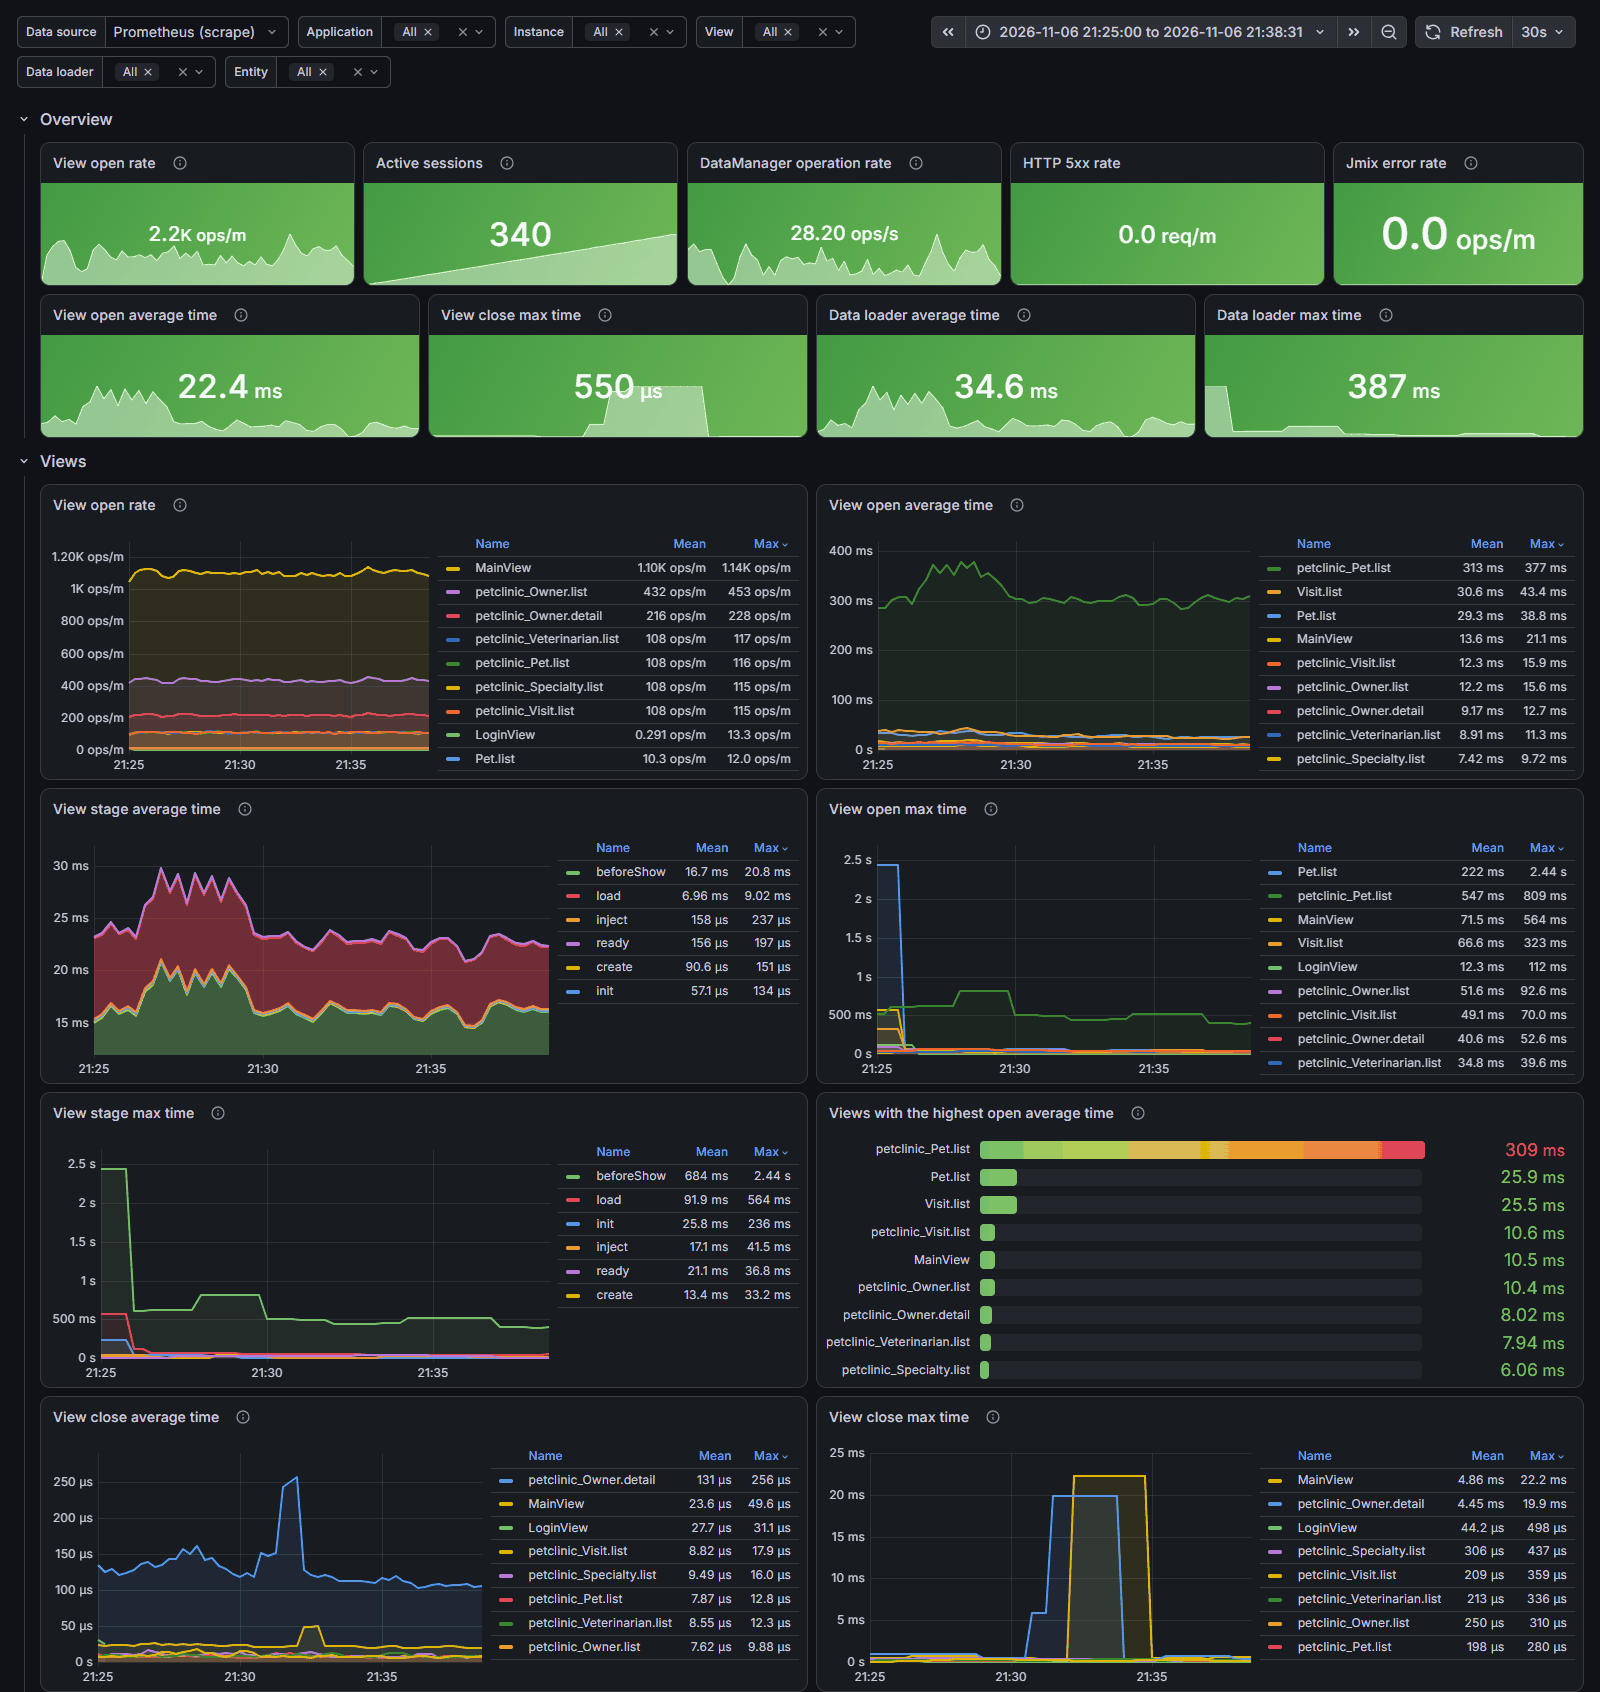
Панель мониторинга «Jmix 3 Full Observability» дополняет метрики трейсами, логами и профилями. Её метрические разделы совпадают с разделами «Jmix 3 Monitoring», а на графиках выводятся exemplars, по которым открывается трейс операции. Метрики панель мониторинга берёт из Prometheus, который собирает их с эндпойнта /actuator/prometheus и сохраняет exemplars, трейсы — из Tempo, логи — из Loki, профили — из Pyroscope (см. Профилирование). При импорте указываются все четыре источника данных. Метрики отбираются по тегу application, а трейсы, логи и профили — по имени сервиса OpenTelemetry, которое по умолчанию равно spring.application.name, поэтому в верхней строке два фильтра: Application и Service.
Разделы, которых нет в «Jmix 3 Monitoring»:
-
Traces — медленные запросы, трейсы с ошибками, медленные этапы жизненного цикла экранов и медленные загрузки
DataManagerс именем сущности и JPQL-запросом. Порог длительности задаётся фильтром Min duration, идентификатор трейса или спана в таблице открывает трейс, Ctrl+щелчок по нему открывает трейс в новой вкладке; -
Logs — число записей лога в минуту по уровням, предупреждения и ошибки, лог с фильтрами по уровню, пользователю (значение MDC
jmixUser, см. Имя пользователя в MDC) и тексту записи. Ссылка в подсказке сегмента столбца на графике числа записей выставляет фильтр Level на уровень этого сегмента, а выделение участка графика мышью сужает интервал всей панели мониторинга; -
Profiles — flame graph времени процессора, выделения памяти и ожидания блокировок.
Ссылки в заголовках панелей разделов Traces, Logs и Profiles открывают в новой вкладке приложения Drilldown → Traces, Logs и Profiles с тем же интервалом времени: для сервиса из фильтра Service или для всех сервисов. В них продолжают разбор, который панель мониторинга не покрывает: в Profiles профиль выгружают в pprof для скрытия служебных кадров (см. Скрытие служебных кадров) и сравнивают профили двух интервалов на вкладке Diff flame graph.
Переходы между сигналами настраиваются не в панели мониторинга, а в источниках данных Grafana, и при импорте JSON-файла не переносятся:
| Переход | Где настраивается |
|---|---|
Ссылка Trace в подсказке exemplar |
Источник данных Prometheus, раздел Exemplars, см. Exemplars |
Кнопка Logs for this span в трейсе |
Источник данных Tempo, Trace to logs |
Кнопка Profiles for this span в трейсе |
Источник данных Tempo, Trace to profiles, см. Связь профилей со спанами |
Ссылка на трейс в подробностях записи лога |
Источник данных Loki, Derived fields |
Окно трейса с деревом спанов, подробности спана и профиль спана — стандартные средства Grafana (Explore), а не часть панели мониторинга. В образе grafana/otel-lgtm у встроенных источников данных настроены все переходы, кроме Trace to profiles. Источник данных Prometheus, который собирает эндпойнт /actuator/prometheus, добавляют отдельно, и ссылку Trace для exemplars в нём задают вручную.
Флейм-графы раздела Profiles начинаются с кадров Tomcat, Spring и Vaadin, приёмы их чтения описаны в разделе Чтение профиля.
Для приложений, которые используют устаревшую схему (jmix.ui.legacy-monitoring-enabled=true), в репозитории есть панель мониторинга «Jmix 2.x». Она рассчитана на сбор через /actuator/prometheus и показывает только экраны и загрузчики данных.
Оповещения
Правило оповещения в Grafana — это запрос PromQL и условие, при выполнении которого Grafana отправляет уведомление: по электронной почте, в мессенджер или во внешнюю систему. Запрос можно взять из элемента визуализации панели мониторинга. Например, правило срабатывает, если 95-й перцентиль загрузки данных держится выше 500 мс в течение пяти минут:
histogram_quantile(0.95, sum by (le) (rate(jmix_ui_data_milliseconds_bucket{lifecycle_name="load"}[2m]))) > 500Запрос рассчитан на метрики, отправленные по OTLP; при сборе через /actuator/prometheus используйте серию jmix_ui_data_seconds_bucket и порог 0.5. Пошаговая настройка правила показана в руководстве по мониторингу.
Настройка для промышленной эксплуатации
-
Группы наблюдений включаются по отдельности: свойства jmix.core.data-observation-enabled и jmix.ui.ui-observation-enabled независимы, а отдельные метрики отключаются свойством
management.metrics.enable. -
LongTaskTimer для наблюдений отключается свойством
management.metrics.observations.ignored-meters=long-task-timer; это почти вдвое сокращает число серий, см. Отключение и фильтрация. -
Гистограммы включаются только для метрик, по которым строятся перцентили и оповещения, см. Перцентили.
-
При экспорте по OTLP интервал отправки
management.otlp.metrics.export.stepзадаётся не меньше1m. -
Число значений тегов определяет число серий: каждое сочетание значений даёт отдельную серию. Jmix объединяет загрузчики без идентификатора в одну серию
<generated>; в своих метриках идентификаторы и имена пользователей как теги не используются. В приложениях с мультиарендностью тегjmix.user.tenantIdумножает число серий на число арендаторов; если разбивка по арендаторам не нужна, тег удаляется биномMeterFilter.ignoreTags("jmix.user.tenantId"). -
Срок хранения метрик в Prometheus задаётся параметром запуска
--storage.tsdb.retention.time(по умолчанию15d). Метрики компактны и нужны для сравнения с прошлыми периодами, поэтому срок их хранения больше, чем у логов, трейсов и профилей. -
Через веб открываются только нужные эндпойнты Actuator (
management.endpoints.web.exposure.include), напримерhealth,prometheusиloggers, и они закрываются от анонимного доступа, например выносом на отдельный порт свойствомmanagement.server.port.