Диагностика производительности
Типичные проблемы производительности приложений Jmix выявляются по метрикам, трейсам, логам и профилям. Подключение и настройка самих сигналов описаны на страницах Метрики, Трассировка, Логирование и в разделе Профилирование.
Порядок разбора
Разбор проблемы обычно идёт от общего к частному, и на каждом шаге используется свой сигнал:
| Шаг | Сигнал | Что он показывает |
|---|---|---|
Обнаружение |
Метрики и оповещения |
Какой экран или какая операция стали медленными и с какого момента |
Поиск запроса |
Трейсы |
Конкретные медленные запросы и самые долгие операции внутри них |
Подробности операции |
Логи с идентификаторами трейса и спана |
SQL-запросы, предупреждения и ошибки, записанные во время операции |
Поиск метода |
Профиль спана или сервиса |
Методы, в которых тратилось процессорное время и выделялась память |
Для разбора нужны включённые наблюдения Jmix (свойства jmix.core.data-observation-enabled и jmix.ui.ui-observation-enabled), трассировка и отправка логов с идентификаторами трейсов. Профили и вывод SQL подключаются, когда нужны подробности.
Разбор начинается с признака проблемы, и разделы ниже следуют этому порядку. Если медленно открывается экран, по его трейсу определяют, на что ушло время: на доступ к данным, на обращения к другим сервисам или на выполнение кода, см. Медленный экран. Эти причины описаны в разделах Доступ к данным, Обращения к другим сервисам и Нагрузка на процессор. Рост потребления памяти и ожидание потоков — отдельные признаки, они описаны в разделах Память и сборка мусора и Блокировки и ожидание потоков.
Медленный экран
Метрика jmix.ui.views показывает длительность этапов жизненного цикла каждого экрана. Если для неё включена гистограмма, 95-й перцентиль по экранам вычисляется запросом:
histogram_quantile(0.95, sum by (le, view_id, lifecycle_name) (rate(jmix_ui_views_seconds_bucket[5m])))По тегу lifecycle_name видно, какой этап экрана медленный. Время загрузки данных экрана показывает метрика jmix.ui.data по загрузчикам, время операций с данными — jmix.data.load по сущностям. Те же данные в готовом виде показывает панель мониторинга «Jmix 3 Monitoring».
Затем по идентификатору экрана находят медленные трейсы. Например, открытия экрана Visit.list дольше 500 мс:
{ name = "view lifecycle" && span.view.id = "Visit.list" && duration > 500ms }В трейсе видно, какой дочерний спан занял большую часть времени:
-
спаны загрузчиков и загрузки данных (
data loader lifecycle,load list of entities) — проблема в доступе к данным, см. Доступ к данным; -
спаны исходящих HTTP-запросов — время ушло на обращение к другому сервису, см. Обращения к другим сервисам;
-
дочерних спанов нет или они короткие — время ушло на код самого экрана, см. Нагрузка на процессор.
Доступ к данным
Если в трейсе медленного экрана больше всего времени занимают спаны загрузчиков и загрузки данных, задержка возникла при доступе к данным. Операция загрузки данных проходит несколько слоёв, и задержка или лишняя работа может возникнуть на любом из них:
-
Код приложения или загрузчик данных экрана формирует JPQL-запрос и выбирает фетч-план.
-
DataManagerприменяет ограничения доступа и передаёт запрос хранилищу данных. -
EclipseLink строит из JPQL-запроса SQL-запрос, добавляя условия Jmix, например условие мягкого удаления, и создаёт сущности из результата. Атрибуты-ссылки из фетч-плана загружаются в том же SQL-запросе или в отдельных.
-
Пул соединений HikariCP выдаёт соединение с базой данных. Если свободных соединений нет, операция ждёт.
-
База данных выполняет SQL-запрос.
Спан загрузки данных, например load list of entities, охватывает всю операцию DataManager, со второго слоя по пятый. Что происходит внутри спана, показывают другие источники:
| Что нужно узнать | Где это видно |
|---|---|
Какой JPQL-запрос выполнен и с какими параметрами |
Атрибуты спана |
Сколько длилась операция целиком |
Длительность спана; метрики jmix.data.load и jmix.data.save |
Какие SQL-запросы построил EclipseLink и сколько их |
Строки лога категории |
Сколько выполнялся каждый SQL-запрос |
Строка |
Сколько операция ждала соединения с базой данных |
Метрики пула соединений HikariCP, см. Пул соединений с базой данных |
На какие методы ушли процессорное время и память |
Профиль корневого спана, см. Связь профилей со спанами |
В Grafana кнопка Logs for this span в подробностях спана открывает строки лога этого трейса, записанные за время спана, в том числе SQL-запросы.
Например, спан load values длился 10,6 мс, а строки лога этого спана содержат SQL-запрос со значениями параметров и время его выполнения, см. SQL-запросы в контексте трейса. JPQL-запрос в атрибутах спана и SQL-запрос в логе показывают, как EclipseLink перевёл запрос: сущность petclinic_Visit стала таблицей PETCLINIC_VISIT, ссылка assignedNurse — столбцом ASSIGNED_NURSE_ID, а Jmix добавил условие мягкого удаления DELETED_DATE IS NULL. Сам SQL-запрос выполнялся 1 мс, остальное время спана ушло на получение соединения и обработку запроса и результата в Jmix и EclipseLink.
Лишние запросы (N+1)
Проблема N+1 возникает, когда для списка из N записей выполняется один запрос на сам список и ещё по запросу на каждую запись. В приложении Jmix она возникает на трёх уровнях, и на каждом выявляется по-своему:
| Уровень | Признак в трейсе | Признак в логе SQL |
|---|---|---|
Код приложения загружает данные в цикле |
Много спанов |
По одному SQL-запросу на каждый спан |
Код обращается к ссылке, которой нет в фетч-плане |
Много спанов |
По одному SQL-запросу на каждый спан |
EclipseLink загружает ссылки отдельными запросами |
Один спан загрузки, никаких признаков в трейсе |
Много SQL-запросов с идентификатором одного спана |
Примеры ниже используют один и тот же набор данных: экран загружает 20 последних визитов, а затем обращается к связанным с ними питомцам или владельцам.
Загрузка в цикле
Код получает список визитов, а затем для каждого визита загружает владельца питомца отдельным вызовом DataManager:
for (Visit visit : visits) {
    dataManager.load(Owner.class) (1)
            .query("select p.owner from Pet p where p = :pet")
            .parameter("pet", visit.getPet())
            .optional()
            .ifPresent(owners::add);
}| 1 | Отдельная загрузка через DataManager для каждого визита. |
В трейсе под спаном view lifecycle (393 мс) идут спан загрузки списка и 20 спанов load entity по 12–37 мс каждый, выполненных друг за другом:
view lifecycle                     393 ms
├── load list of entities
├── load entity                    12–37 ms each
│   ... 20 load entity spans in total, one after another
└── load entity
У всех этих спанов одинаковый атрибут jpql.query и разные значения jpql.parameters. Такую загрузку заменяют одним запросом для всех записей, например с условием where p in :pets, или добавляют связанные данные в фетч-план исходного запроса.
Обращение к ссылке вне фетч-плана
Если атрибута-ссылки нет в фетч-плане, Jmix загружает её при первом обращении через DataManager по идентификатору, см. Ленивая загрузка. Так же ведёт себя столбец таблицы UI, привязанный к ссылке, которой нет в фетч-плане загрузчика. Код, который читает такую ссылку у каждой записи списка, выполняет отдельную загрузку на каждую запись:
List<Visit> visits = dataManager.load(Visit.class)
        .query("select v from Visit v order by v.visitStart desc")
        .maxResults(20)
        .fetchPlan(FetchPlan.BASE) (1)
        .list();
List<String> petNames = new ArrayList<>();
for (Visit visit : visits) {
    petNames.add(visit.getPet().getName()); (2)
}| 1 | Ссылки pet в фетч-плане нет. |
| 2 | Обращение к ссылке загружает питомца по идентификатору. |
Картина в трейсе похожа на загрузку в цикле: 20 спанов load entity, здесь для сущности petclinic_Pet:
view lifecycle
├── load list of entities          petclinic_Visit
├── load entity                    petclinic_Pet
│   ... 20 load entity spans in total, without jpql.query
└── load entity                    petclinic_Pet
Отличие — у этих спанов нет атрибута jpql.query, потому что сущность загружается по идентификатору. Ссылку добавляют в фетч-план исходного запроса, и тогда питомцы загружаются вместе с визитами.
Отдельные запросы внутри EclipseLink
Способ загрузки атрибута-ссылки из фетч-плана задаёт атрибут fetch свойства фетч-плана (перечисление FetchMode): AUTO — способ выбирает фреймворк, JOIN — соединение таблиц в том же SQL-запросе, BATCH — один отдельный запрос для всех связанных сущностей, UNDEFINED — правила JPA, то есть отдельный запрос для каждой ссылки. При режиме UNDEFINED EclipseLink выполняет SQL-запрос на каждую загружаемую ссылку. В трейсе это не видно: вся работа выполняется внутри одного вызова DataManager.
Например, спан load list of entities длился 82 мс. Его строки лога показывают, что кроме запроса списка EclipseLink выполнил отдельные запросы SELECT … FROM PETCLINIC_PET WHERE (ID = ?) и SELECT … FROM PETCLINIC_OWNER WHERE (ID = ?) для каждого питомца и владельца — всего 17 SQL-запросов. Такие загрузки находят запросом LogQL, который считает SQL-запросы по идентификатору спана, см. SQL-запросы в контексте трейса. Причину ищут в фетч-плане: режим загрузки ссылки и состав атрибутов.
Другие проблемы доступа к данным
| Признак | Вероятная причина | Что проверить |
|---|---|---|
Атрибут |
Ошибка в запросе загрузчика или в коде |
Запрос загрузчика или вызов |
Спан длится долго, а время SQL-запросов ( |
Ожидание соединения из пула или обработка большого числа записей |
Метрики пула соединений, число загружаемых записей, профиль спана |
Время SQL-запроса ( |
Медленный запрос в базе данных: нет подходящего индекса, неудачный план выполнения |
План выполнения SQL-запроса из лога в базе данных, например командой |
Ожидание соединения с базой данных
Если все соединения пула заняты, операции доступа к данным ждут, пока соединение освободится. Время ожидания входит в длительность спанов загрузки данных, но не во время SQL-запросов в логе. Признаки в метриках HikariCP:
-
hikaricp.connections.pendingбольше нуля — есть потоки, ожидающие соединения; -
hikaricp.connections.activeравноhikaricp.connections.max— все соединения заняты; -
растёт
hikaricp.connections.acquire— время получения соединения; -
растёт
hikaricp.connections.timeout— операции не дождались соединения и завершились ошибкой.
Пул бывает занят из-за медленных SQL-запросов, долгих транзакций, обращений к другим сервисам внутри транзакции или слишком маленького размера пула. Подробнее о метриках пула — Пул соединений с базой данных.
Обращения к другим сервисам
Если в трейсе медленного экрана больше всего времени занимают спаны исходящих HTTP-запросов, в том числе запросов REST DataStore, время ушло на обращение к другому сервису. Если второе приложение тоже отправляет трейсы и контекст трассировки передаётся, его спаны входят в тот же трейс, см. Передача контекста между сервисами. По трейсу видно, сколько времени заняла обработка во втором приложении и сколько — передача запроса и ответа.
Время ответа других сервисов, сгруппированное по uri, method и status, показывает метрика Spring Boot http.client.requests.
Нагрузка на процессор
Если спан длится долго, а дочерних спанов у него нет или они короткие, время ушло на код внутри самого спана. Какие методы его выполняли, показывает профиль процессора корневого спана запроса, см. Связь профилей со спанами. Для нагрузки, не связанной с конкретным запросом, например фоновых задач, используется профиль процессора всего сервиса за выбранный интервал в Drilldown → Profiles.
Загрузку процессора приложением и сервером показывают метрики Spring Boot process.cpu.usage и system.cpu.usage.
Сравнение длительности спана с процессорным временем в его профиле различает два случая. Если они близки, запрос выполнял вычисления. Если процессорного времени заметно меньше, запрос в основном ждал: ответа базы данных, соединения из пула, другого сервиса или освобождения блокировки, см. Блокировки и ожидание потоков.
Память и сборка мусора
Проблемы с памятью не всегда проявляются в медленных запросах, поэтому их выявляют по метрикам JVM. Состояние памяти JVM показывают метрики Spring Boot:
| Метрика | Что показывает |
|---|---|
|
Занятая память по областям |
|
Доля долгоживущей области кучи, занятой после последней сборки мусора. Если она растёт от сборки к сборке, приложение удерживает всё больше объектов, см. Утечка памяти |
|
Длительность и частота пауз сборки мусора |
|
Доля процессорного времени, затраченного на сборку мусора |
Частые сборки мусора вызывает интенсивное выделение памяти. Где выделяется память, показывает профиль выделения памяти: для отдельного запроса — профиль корневого спана, для приложения в целом — профиль сервиса в Drilldown → Profiles. Профиль выделения памяти включается в Java-агенте Pyroscope, см. Настройка для промышленной эксплуатации.
Утечка памяти
Утечка памяти возникает, когда на объекты, которые приложению больше не нужны, остаются ссылки, и сборщик мусора не может их удалить. Занятая память растёт постепенно, а когда её не хватает, приложение завершает операции ошибкой OutOfMemoryError.
Признак утечки в метриках — рост jvm.memory.usage.after.gc при неизменной нагрузке: после каждой сборки мусора в долгоживущей области кучи остаётся больше объектов, чем после предыдущей. Вместе с ним растут частота пауз jvm.gc.pause и доля jvm.gc.overhead. Рост занятой памяти при росте нагрузки утечкой не является, поэтому память сравнивают за периоды с одинаковой нагрузкой.
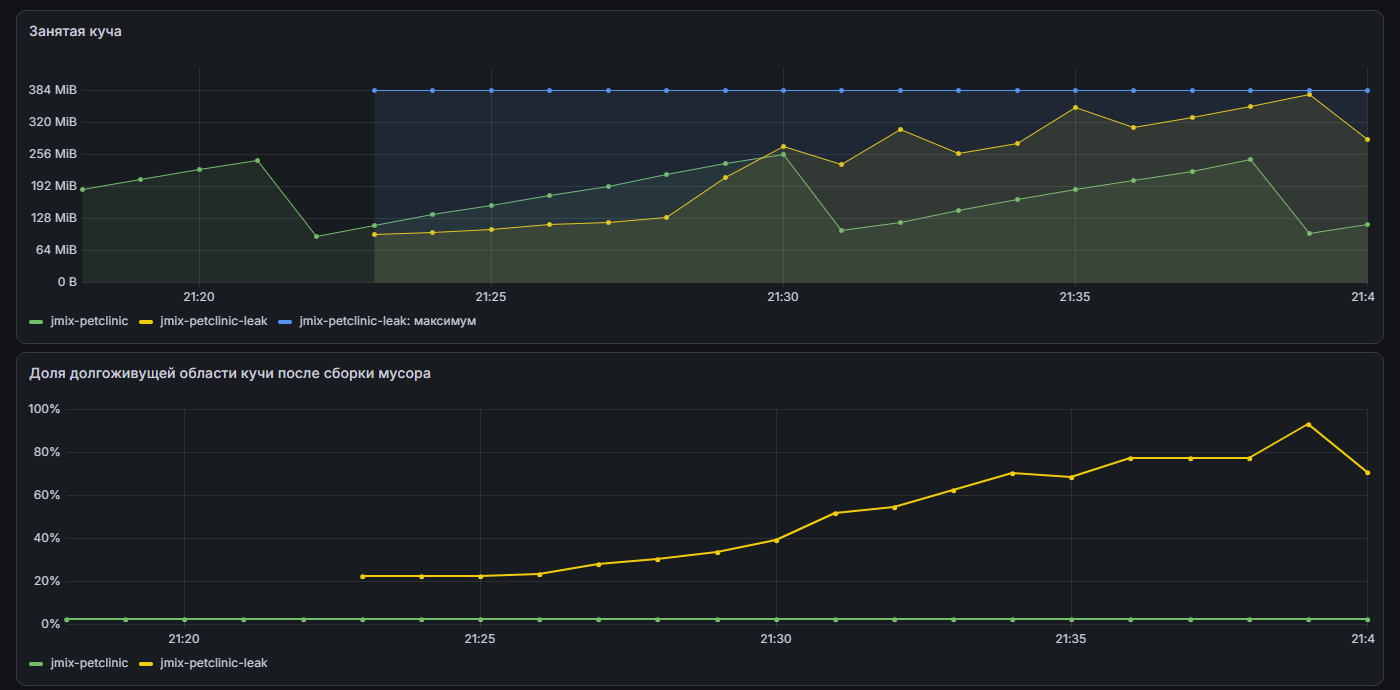
Например, два экземпляра Petclinic работают одновременно под одинаковой нагрузкой. В экземпляр jmix-petclinic-leak для примера добавлен кеш без ограничения размера. У приложения без утечки занятая куча после каждой сборки мусора возвращается примерно к 100 МиБ, а доля долгоживущей области после сборки не меняется. У экземпляра с утечкой каждый следующий минимум занятой кучи выше предыдущего, а доля долгоживущей области после сборки за 15 минут выросла с 22 до 93 % при пределе кучи 384 МиБ. Через три минуты после этого в логе приложения появилась ошибка OutOfMemoryError.
Направление поиска подсказывает сравнение с числом активных HTTP-сессий — метрикой tomcat.sessions.active.current, которая публикуется при server.tomcat.mbeanregistry.enabled=true. Если память растёт вместе с числом сессий, объекты удерживаются состоянием сессий пользователей, в том числе открытыми экранами. Если связи с сессиями нет, проверяют кеши, статические коллекции и переменные ThreadLocal.
Профиль выделения памяти показывает, где память выделяется, но не какие объекты остаются в куче. Метод, который выделяет много памяти, не обязательно причина утечки: выделенные им объекты могут удаляться при первой же сборке мусора.
Какие объекты удерживаются и какие ссылки не дают их удалить, показывает снимок кучи (heap dump). Его получают с эндпойнта Actuator heapdump или автоматически при ошибке, параметром JVM -XX:+HeapDumpOnOutOfMemoryError. Снимок записывается при остановленном приложении и занимает на диске примерно столько же, сколько занятая куча. Снимок открывают в анализаторе кучи, например Eclipse Memory Analyzer: дерево доминаторов показывает объекты, которые удерживают больше всего памяти, а путь до корней сборки мусора — цепочку ссылок, из-за которой объект не удаляется.
Снимок кучи содержит все данные из памяти приложения, в том числе персональные данные и пароли. По умолчанию эндпойнт heapdump не открыт через веб; если его открывают, доступ к нему ограничивают так же, как к остальным эндпойнтам Actuator, см. Настройка для промышленной эксплуатации.
Блокировки и ожидание потоков
Метрика jvm.threads.states показывает число потоков в каждом состоянии. Рост числа потоков в состояниях blocked и waiting при неизменной нагрузке означает, что потоки ждут друг друга или внешних ресурсов.
Где именно потоки ждут, показывает профиль блокировок Pyroscope. В Grafana он представлен двумя типами: mutex — ожидание мониторов synchronized, block — ожидание блокировок java.util.concurrent, например ReentrantLock. Агент записывает ожидания длиннее порога, заданного переменной PYROSCOPE_PROFILER_LOCK, см. Настройка для промышленной эксплуатации.
Один из источников ожидания в интерфейсе Jmix — блокировка сессии Vaadin: запросы одной сессии пользователя обрабатываются по очереди, и долгая операция в обработчике экрана задерживает остальные запросы этой сессии. Как это выглядит в профиле и как этого избежать, описано в разделе Блокировка сессии Vaadin.
См. также
-
Наблюдаемость — обзор наблюдаемости и связь между сигналами
-
Наблюдаемость в промышленной эксплуатации — настройка наблюдаемости для постоянной работы
-
Извлечение данных — фетч-планы и режимы загрузки ссылок
-
Observability: Monitoring — пример поиска медленного экрана по метрикам